<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://chanhyukyun.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://chanhyukyun.github.io/" rel="alternate" type="text/html" /><updated>2025-02-19T03:34:42+09:00</updated><id>https://chanhyukyun.github.io/feed.xml</id><title type="html">Yun’s diary</title><subtitle>윤찬혁의 개발일지입니다.</subtitle><author><name>Chanhyuk Yun</name></author><entry><title type="html">How to use docker</title><link href="https://chanhyukyun.github.io/linux/docker/" rel="alternate" type="text/html" title="How to use docker" /><published>2024-09-14T00:00:00+09:00</published><updated>2024-09-14T00:00:00+09:00</updated><id>https://chanhyukyun.github.io/linux/docker</id><content type="html" xml:base="https://chanhyukyun.github.io/linux/docker/"><![CDATA[<h4 id="docker-소개">Docker 소개</h4>

<h4 id="how-to-use-docker">How to use docker</h4>

<ol>
  <li>Download wanted docker image, use the codes below</li>
</ol>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c"># For example, download pytorch image</span>
docker pull pytorch/pytorch
</code></pre></div></div>

<ol>
  <li>Create docker container</li>
</ol>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c"># Name(image): pytorch/pytorch</span>
<span class="c"># Name(container): container_name</span>
<span class="c"># -i: interactive model enable</span>
<span class="c"># -t: tty mode enable</span>
<span class="c"># -d: debug mode enable</span>
<span class="c"># --gpus all: use all of accessible gpus</span>
<span class="c"># --gpus '"device=0,2"': use gpus:0 and 2 only</span>
<span class="c"># --name container_name: declare name of the container</span>
<span class="c"># -v: mount option</span>
<span class="c"># --shm-size: allocate memory</span>
<span class="c"># --restart=always: enable executing docker container without precedent 'docker start'</span>
docker run <span class="nt">-itd</span> <span class="nt">--gpus</span> <span class="s1">'"device=0,2"'</span> <span class="nt">-v</span> local_dir:remote_dir <span class="nt">-v</span> local_dir2:remote_dir2 <span class="nt">--shm-size</span> 20G <span class="nt">--name</span> container_name <span class="nt">--restart</span><span class="o">=</span>always pytorch/pytorch


<span class="c"># Examples</span>
docker run <span class="nt">-it</span> <span class="nt">-v</span> ~/Desktop/mnt/Privacy_preserving:/workspace/mnt <span class="nt">-v</span> /data/DDE:/workspace/local <span class="nt">--shm-size</span> 20G <span class="nt">--gpus</span> all <span class="nt">--name</span> ych <span class="nt">--restart</span><span class="o">=</span>always pytorch/pytorch

<span class="c"># -v /tmp/.X11-unix:/tmp/.X11-unix -e DISPLAY=unix$DISPLAY</span>
<span class="c"># Enable docker container to work with X Windows (necessary when using COLMAP in docker container)</span>
<span class="c"># Extra 'xhost +local:docker_container' is required</span>
docker run <span class="nt">-it</span> <span class="nt">-v</span> ~/Desktop/mnt/Privacy_preserving:/workspace/mnt <span class="nt">-v</span> /data/DDE:/workspace/local <span class="nt">-v</span> /tmp/.X11-unix:/tmp/.X11-unix <span class="nt">-e</span> <span class="nv">DISPLAY</span><span class="o">=</span>unix<span class="nv">$DISPLAY</span> <span class="nt">--shm-size</span> 20G <span class="nt">--gpus</span> all <span class="nt">--name</span> ych <span class="nt">--restart</span><span class="o">=</span>always cksgurdbs/ych_colmap2
</code></pre></div></div>

<ol>
  <li>Execute the container</li>
</ol>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>docker <span class="nb">exec</span> <span class="nt">-it</span> container_name bash
</code></pre></div></div>

<ol>
  <li>Stop docker container</li>
</ol>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>docker stop container_name
</code></pre></div></div>

<ol>
  <li>Remove docker container</li>
</ol>

<p>Stop the docker container before you remove it</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>docker <span class="nb">rm </span>container_name
</code></pre></div></div>]]></content><author><name>Chanhyuk Yun</name></author><category term="Linux" /><category term="Linux" /><summary type="html"><![CDATA[Docker 소개]]></summary></entry><entry><title type="html">Paper review: Revealing scenes by inverting Structure-from-Motion reconstructions</title><link href="https://chanhyukyun.github.io/paper_review/pittaluga_cvpr_2019/" rel="alternate" type="text/html" title="Paper review: Revealing scenes by inverting Structure-from-Motion reconstructions" /><published>2024-09-14T00:00:00+09:00</published><updated>2024-09-14T00:00:00+09:00</updated><id>https://chanhyukyun.github.io/paper_review/pittaluga_cvpr_2019</id><content type="html" xml:base="https://chanhyukyun.github.io/paper_review/pittaluga_cvpr_2019/"><![CDATA[]]></content><author><name>Chanhyuk Yun</name></author><category term="Paper_review" /><category term="3D computer vision" /><category term="Deep learning" /><summary type="html"><![CDATA[]]></summary></entry><entry><title type="html">Privacy-preserving visual localization</title><link href="https://chanhyukyun.github.io/paper_review/privacy_preserving/" rel="alternate" type="text/html" title="Privacy-preserving visual localization" /><published>2024-09-14T00:00:00+09:00</published><updated>2024-09-14T00:00:00+09:00</updated><id>https://chanhyukyun.github.io/paper_review/privacy_preserving</id><content type="html" xml:base="https://chanhyukyun.github.io/paper_review/privacy_preserving/"><![CDATA[<p>privacy-preserving visual localization 소개</p>]]></content><author><name>Chanhyuk Yun</name></author><category term="Paper_review" /><category term="3D computer vision" /><category term="Deep learning" /><summary type="html"><![CDATA[privacy-preserving visual localization 소개]]></summary></entry><entry><title type="html">Paper review: Privacy Preserving Image-based Localization</title><link href="https://chanhyukyun.github.io/paper_review/speciale_cvpr_2019/" rel="alternate" type="text/html" title="Paper review: Privacy Preserving Image-based Localization" /><published>2024-09-14T00:00:00+09:00</published><updated>2024-09-14T00:00:00+09:00</updated><id>https://chanhyukyun.github.io/paper_review/speciale_cvpr_2019</id><content type="html" xml:base="https://chanhyukyun.github.io/paper_review/speciale_cvpr_2019/"><![CDATA[]]></content><author><name>Chanhyuk Yun</name></author><category term="Paper_review" /><category term="3D computer vision" /><summary type="html"><![CDATA[]]></summary></entry><entry><title type="html">Visual localization</title><link href="https://chanhyukyun.github.io/paper_review/visual_localization/" rel="alternate" type="text/html" title="Visual localization" /><published>2024-09-14T00:00:00+09:00</published><updated>2024-09-14T00:00:00+09:00</updated><id>https://chanhyukyun.github.io/paper_review/visual_localization</id><content type="html" xml:base="https://chanhyukyun.github.io/paper_review/visual_localization/"><![CDATA[<p>visual localization 소개</p>]]></content><author><name>Chanhyuk Yun</name></author><category term="Paper_review" /><category term="3D computer vision" /><summary type="html"><![CDATA[visual localization 소개]]></summary></entry><entry><title type="html">Multivariate data analysis</title><link href="https://chanhyukyun.github.io/data_analysis/kt_06_2/" rel="alternate" type="text/html" title="Multivariate data analysis" /><published>2024-09-11T00:00:00+09:00</published><updated>2024-09-11T00:00:00+09:00</updated><id>https://chanhyukyun.github.io/data_analysis/kt_06_2</id><content type="html" xml:base="https://chanhyukyun.github.io/data_analysis/kt_06_2/"><![CDATA[<p>Date: 2024-09-11</p>

<p>이번 글에서는 변수가 2개 이상인 이변량 데이터의 분석 중, 모든 변수가 숫자형 데이터인 경우에 관하여 다루도록 하겠습니다.</p>

<h4 id="숫자형-이변량-데이터-multivariate-data-분석">숫자형 이변량 데이터 (Multivariate data) 분석</h4>

<p><img src="" alt="img1" /></p>

<p>숫자형 이변량 데이터 분석은 그래프를 그려서 분석하는 산점도 (scatter plot) 방법과 수치적으로 얼마나 두 데이터가 선형 관계에 가까운지 파악하는 방법이 있습니다. 선형 관계에 가까운지 파악하는 방법으로는 공분산 (covariance)과 상관계수의 크기를 보는 방법이 있으며, p-value의 크기를 보고도 확인할 수 있습니다. 데이터간 관계가 선형 관계가 아닐 수 있기 때문에, 그래프를 통한 분석을 선행적으로 수행하고 선형 관계로 판단되면 수치적으로 검증합니다.</p>

<p>그래프로 확인하는 방법은</p>

<ul>
  <li>
    <p>p-value (p-값)</p>
  </li>
  <li>
    <p>공분산 (covariance)</p>
  </li>
  <li>
    <p>상관계수 (correlation covariance)</p>
  </li>
</ul>

<p>[r=\frac{\frac{\sum{(x-\bar{x})(y-\bar{y})}}{n}}{\sqrt{  \frac{  \sum{(x-\bar{x})^2}  }{ n }} \times \frac{\sum{(y-\bar{y})^2}}{n} }]</p>

<p>상관계수는 scipy.stats.pearsonr() 함수를 통해 구할 수 있으며, 해당 함수는 p-value 또한 반환합니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">seaborn</span> <span class="k">as</span> <span class="n">sns</span>
<span class="kn">import</span> <span class="nn">scipy.stats</span> <span class="k">as</span> <span class="n">spsc</span>

<span class="n">sns</span><span class="p">.</span><span class="n">scatterplot</span><span class="p">(</span><span class="n">x</span><span class="o">=</span><span class="s">'feature'</span><span class="p">,</span> <span class="n">y</span><span class="o">=</span><span class="s">'target'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">)</span>
<span class="n">sns</span><span class="p">.</span><span class="n">pairplot</span><span class="p">(</span><span class="n">dataframe</span><span class="p">)</span>
<span class="n">sns</span><span class="p">.</span><span class="n">regplot</span><span class="p">(</span><span class="n">x</span><span class="o">=</span><span class="s">'feature'</span><span class="p">,</span> <span class="n">y</span><span class="o">=</span><span class="s">'target'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">)</span>
<span class="n">sns</span><span class="p">.</span><span class="n">jointplot</span><span class="p">(</span><span class="n">x</span><span class="o">=</span><span class="s">'feature'</span><span class="p">,</span> <span class="n">y</span><span class="o">=</span><span class="s">'target'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">)</span>

<span class="c1"># 모든 숫자형 변수들간 상관계수 계산 및 시각화
</span><span class="n">display</span><span class="p">(</span><span class="n">dataframe</span><span class="p">.</span><span class="n">corr</span><span class="p">())</span>
<span class="n">sns</span><span class="p">.</span><span class="n">heatmap</span><span class="p">(</span><span class="n">dataframe</span><span class="p">.</span><span class="n">corr</span><span class="p">(),</span>
            <span class="n">annot</span><span class="o">=</span><span class="bp">True</span><span class="p">,</span> <span class="c1"># 상관계수 표기 여부
</span>            <span class="n">fmt</span><span class="o">=</span><span class="s">'.3f'</span><span class="p">,</span> <span class="c1"># 상관계수 표기 시 숫자 형식
</span>            <span class="c1">#cmap= , # 색상 옵션, 이번에는 생략
</span>            <span class="n">vmin</span><span class="o">=-</span><span class="mi">1</span><span class="p">,</span> <span class="n">vmax</span><span class="o">=</span><span class="mi">1</span>
            <span class="p">)</span>

<span class="n">spsc</span><span class="p">.</span><span class="n">pearsonr</span><span class="p">(</span><span class="n">dataframe</span><span class="p">[</span><span class="s">'feature'</span><span class="p">],</span> <span class="n">dataframe</span><span class="p">[</span><span class="s">'target'</span><span class="p">])</span>
</code></pre></div></div>]]></content><author><name>Chanhyuk Yun</name></author><category term="Data_analysis" /><category term="Python" /><category term="Data analysis" /><summary type="html"><![CDATA[Date: 2024-09-11]]></summary></entry><entry><title type="html">Business problem solving strategy based on data</title><link href="https://chanhyukyun.github.io/data_analysis/kt_05_1/" rel="alternate" type="text/html" title="Business problem solving strategy based on data" /><published>2024-09-10T00:00:00+09:00</published><updated>2024-09-10T00:00:00+09:00</updated><id>https://chanhyukyun.github.io/data_analysis/kt_05_1</id><content type="html" xml:base="https://chanhyukyun.github.io/data_analysis/kt_05_1/"><![CDATA[<p>Date: 2024-09-10</p>

<p>이번 글에서는 Business에서 데이터 기반의 문제 해결 방법에 대해 간략하게 다루겠습니다.</p>

<h4 id="crisp-dm이란">CRISP-DM이란?</h4>

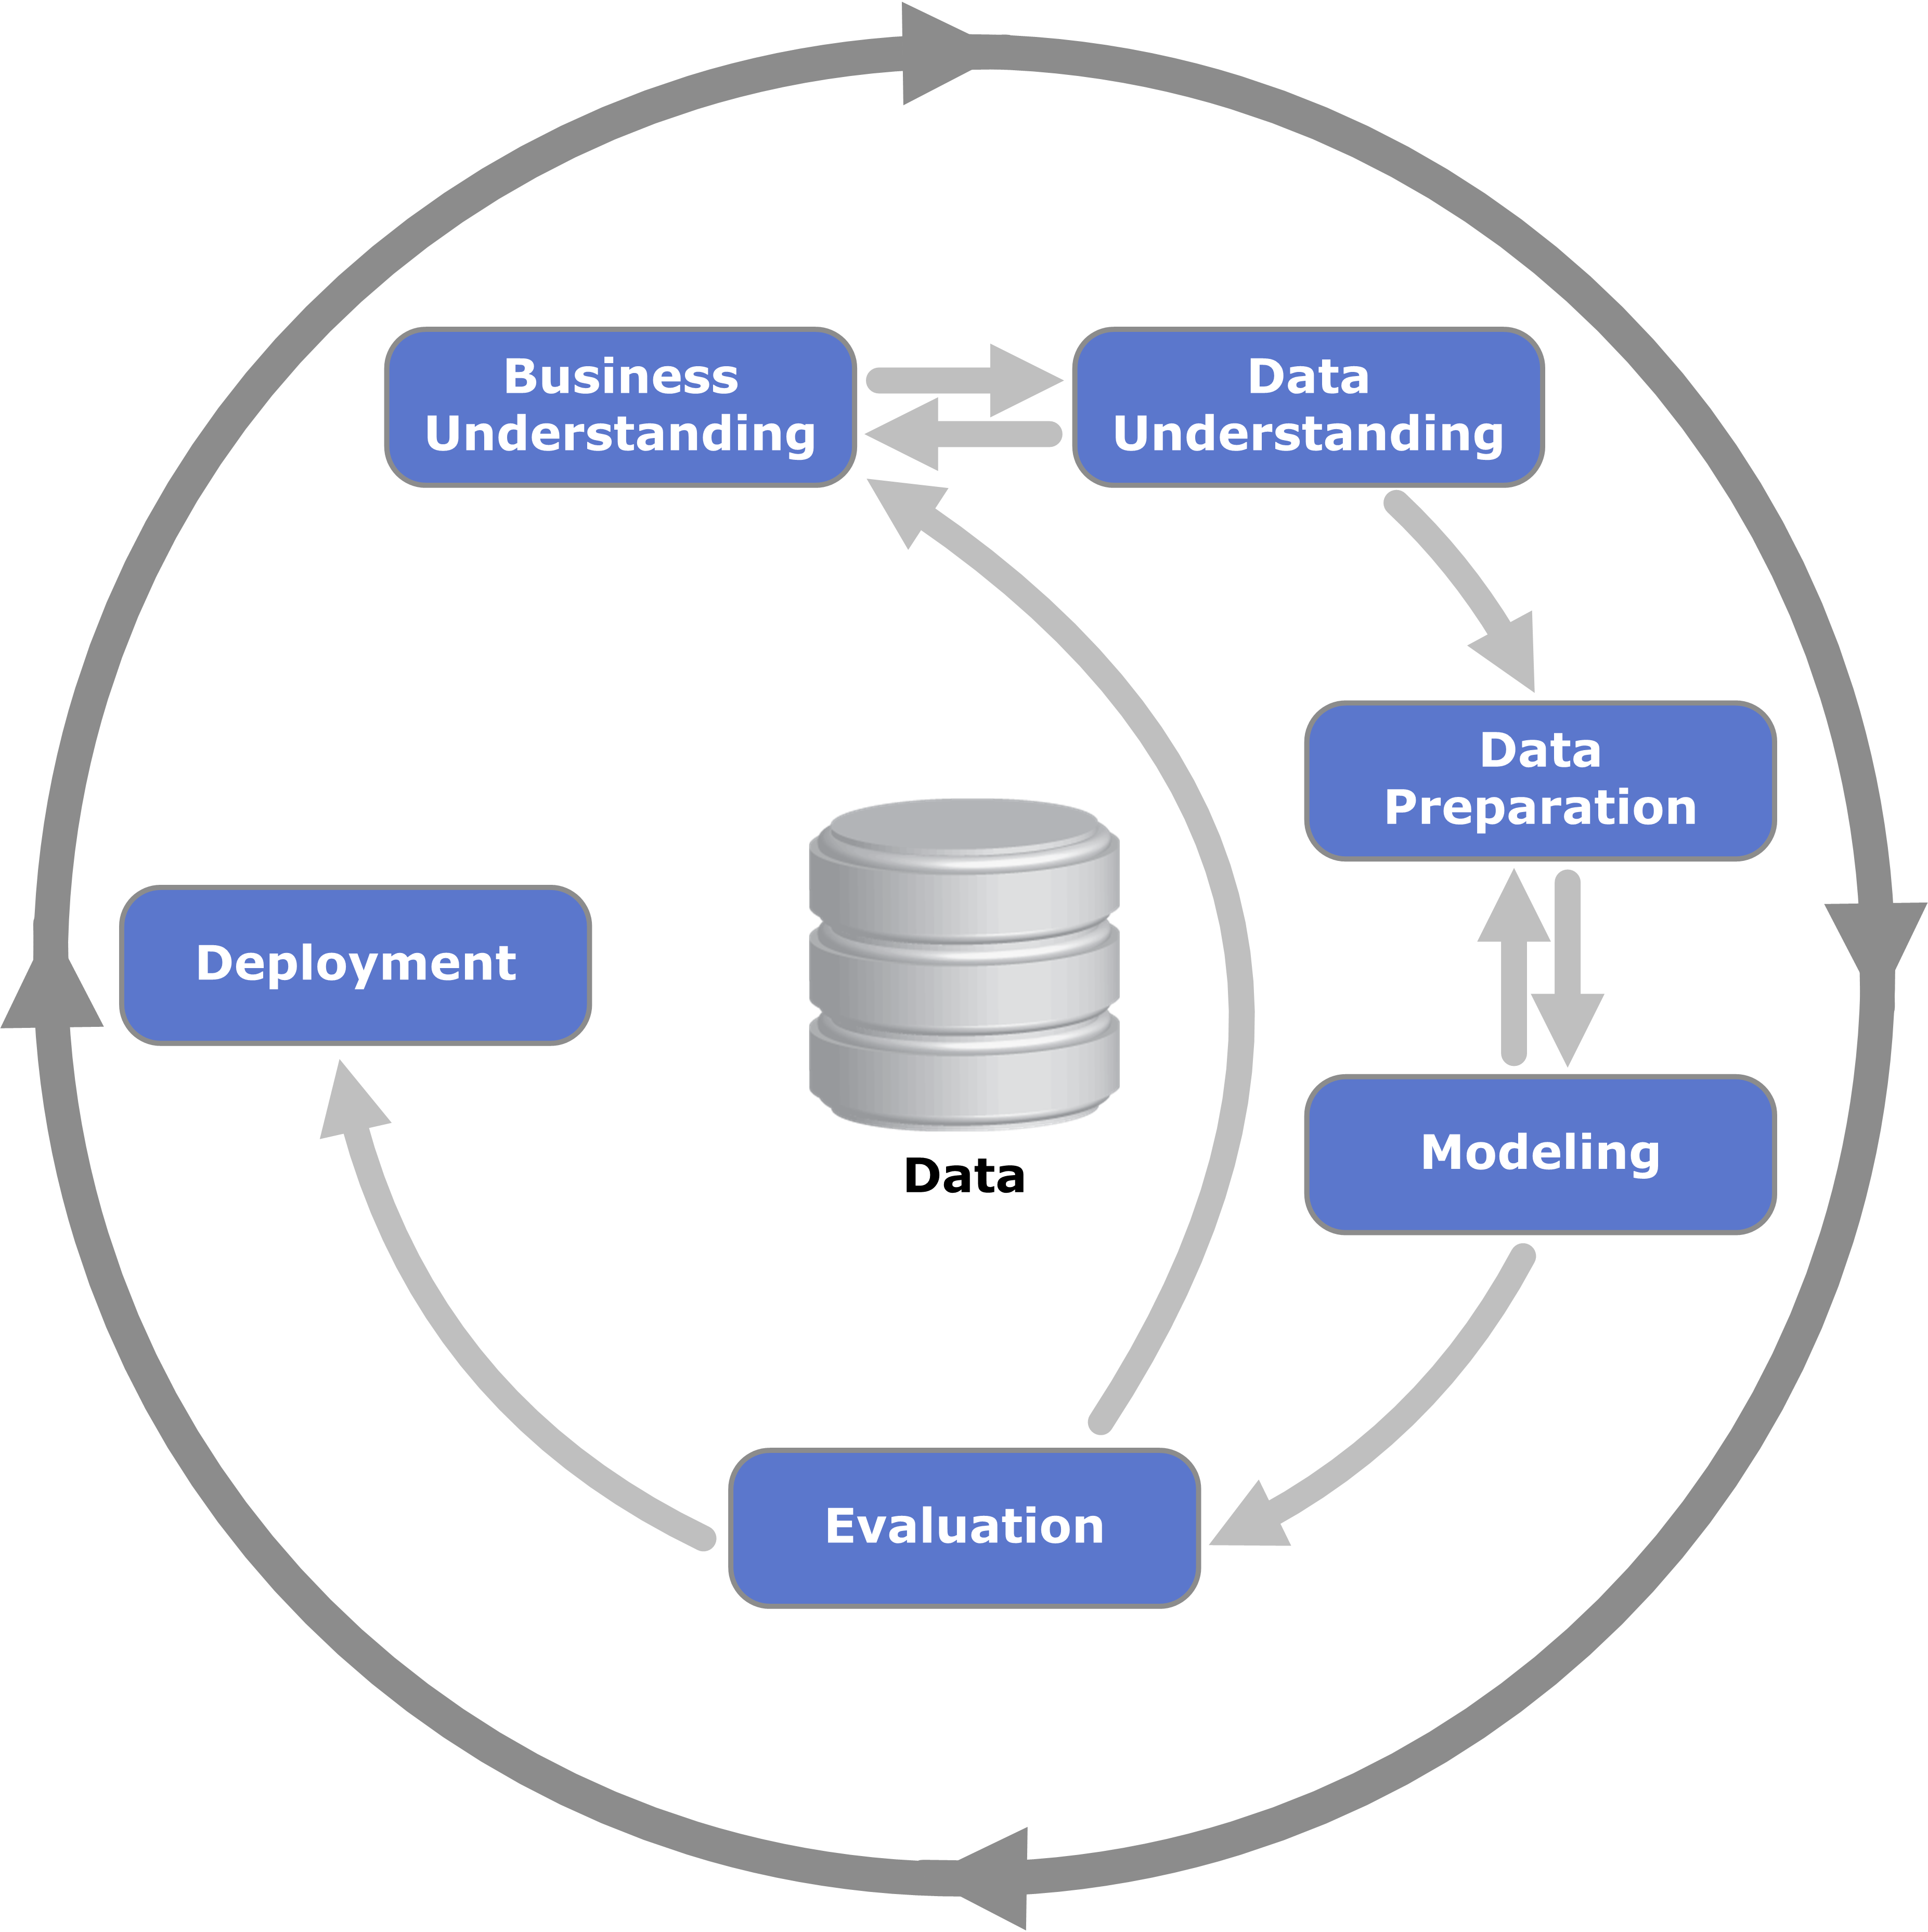
<p>CRISP-DM은 the CRoss Industry Standard Process for Data Mining의 약자로, 데이터 기반의 business 문제 해결 방법론에 관한 모델입니다.
여러 회사에서 사용하는 문제 해결 방법론의 기반이 되므로, 이 방법에 입각해서 데이터를 분석하는 습관을 들입시다.</p>

<p><br /></p>

<p><img src="https://octaviods.com/images/CRISP-DM_Process_Diagram.png" alt="img1" width="70%" height="70%" class="align-center" /></p>
<center>이미지 출처: https://octaviods.com/blog/post-seven/</center>

<blockquote>
  <p>CRISP-DM은 총 6단계로 구성되며, 각 단계는 다음과 같습니다.</p>
</blockquote>

<ol>
  <li>
    <p>Business understanding</p>
  </li>
  <li>
    <p>Data understanding</p>
  </li>
  <li>
    <p>Data preparation</p>
  </li>
  <li>
    <p>Modeling</p>
  </li>
  <li>
    <p>Evaluation</p>
  </li>
  <li>
    <p>Deployment</p>
  </li>
</ol>

<p><br /></p>

<h4 id="1-business-understanding">1. Business Understanding</h4>

<p>CRISP-DM의 가장 첫 단계이기도 하면서, 데이터 이해 (data understanding)와 평가 (evaluataion) 단계 이후 다시 회귀하기도 하는 단계입니다.
이 단계에서는 문제의 요인 파악을 위한 가설을 수립하게 되며, 이후 단계에서 검토를 하게 됩니다.
해당 가설은 버릴 것으로 기대되는 기존 가설 (귀무가설, null hypothesis)과 대립된다고 하여 대립가설 (alternative hypothesis)이라고 불립니다.</p>

<p><br /></p>

<h4 id="2-data-understanding">2. Data understanding</h4>

<p>다양한 데이터를 하나의 데이터프레임으로 만들어 분석하는 단계입니다. 이미 확보된 데이터 중 그대로 사용 가능한 데이터 또는 가공해야 사용 가능한 데이터를 가공하여 data pipeline과 data environment를 검토 및 이를 위한 과제를 수행해야 하며, 확보하지 못한 데이터 중 취득 가능한 데이터를 위한 리소스 산정을 합니다.</p>

<p>데이터 분석은 EDA(Exploratory Data Analysis, 탐색적 데이터 분석) CDA (Confirmatory Data Analysis, 확증적 데이터 분석)로 나뉘며, EDA는 데이터를 살펴보면서 insight를 도출해내는 방법이고 CDA는 가설을 세운 후 데이터를 통해 검증하는 방법입니다.</p>

<p>또한 개별 변수 (feature)의 분포를 분석하는지, 아니면 두 변수 사이를 비교하여 분석하는지에 따라 단변량 분석과 이변량 분석으로 나뉘기도 합니다.</p>

<p><br /></p>

<h4 id="3-data-preparation">3. Data preparation</h4>

<p>모델링을 위한 데이터 구조를 만드는 단계</p>

<p><br /></p>

<h4 id="4-modeling">4. Modeling</h4>

<p>데이터 안에 담겨있는 패턴을 찾아 정리하는 단계로, 수식이 만들어짐</p>

<p><br /></p>

<h4 id="5-evaluation">5. Evaluation</h4>

<p>기술적 관점에서 평가</p>

<p>비즈니스 관점에서 평가도 필수적임</p>

<p><br /></p>

<h4 id="6-deployment">6. Deployment</h4>

<p>시스템 구현 및 모델 관리</p>]]></content><author><name>Chanhyuk Yun</name></author><category term="Data_analysis" /><category term="Business" /><summary type="html"><![CDATA[Date: 2024-09-10]]></summary></entry><entry><title type="html">How to plot data using Python</title><link href="https://chanhyukyun.github.io/python/kt_05_2/" rel="alternate" type="text/html" title="How to plot data using Python" /><published>2024-09-10T00:00:00+09:00</published><updated>2024-09-10T00:00:00+09:00</updated><id>https://chanhyukyun.github.io/python/kt_05_2</id><content type="html" xml:base="https://chanhyukyun.github.io/python/kt_05_2/"><![CDATA[<p>Date: 2024-09-10</p>

<p>이번 글에서는 Python에서 데이터를 시각화하는 방법에 대해 간략하게 다루겠습니다.</p>

<h4 id="데이터-시각화가-필요한-이유">데이터 시각화가 필요한 이유</h4>

<p>데이터 분석은 그 방법마다 알맞은 가정이 필요하며, 이 가정을 선택하기 위한 business insight가 필요합니다. 이를 파악하기 위해 데이터를 시각화하고 그 특성을 파악할 수 있도록 하는 과정이 필요합니다.</p>

<p>데이터 시각화를 위한 다양한 방법이 있지만, 이번 글에서는 Python의 두 라이브러리, matplotlib의 pyplot과 seaborn을 사용하는 방법을 다루도록 하겠습니다.</p>

<p><br /></p>

<h4 id="matplotlibpyplot">matplotlib.pyplot</h4>

<p>matplotlib은 plot을 그리기 위해 많이 사용되는 Python 라이브러리로, 라이브러리 호출은 보편적으로 다음과 같이 이뤄집니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># matplotlb 라이브러리 내의 pyplot 모듈 호출
</span><span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
</code></pre></div></div>

<p>1차원 데이터 (series)를 시각화하는 방법은 다음과 같습니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 데이터를 그리는 단계
</span><span class="n">plt</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="n">series</span><span class="p">)</span>

<span class="c1"># 그린 결과를 화면에 띄우는 단계
</span><span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>

<p>2차원 데이터 (dataframe)를 시각화하는 방법은 다음과 같습니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">plt</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="n">dataframe</span><span class="p">[</span><span class="s">'column1'</span><span class="p">],</span> <span class="n">dataframe</span><span class="p">[</span><span class="s">'column2'</span><span class="p">])</span>
<span class="c1"># 위 코드는 다음과 같이 사용할 수도 있습니다.
</span><span class="n">plt</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="s">'column1'</span><span class="p">,</span> <span class="s">'column2'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">)</span>

<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>

<p><br /></p>

<p>데이터 시각화 과정 중에는 차트 설명이나 가독성을 위해 차트를 꾸밀 필요가 있으며, plt.show() 전에 추가되어 다음과 같은 기능을 구현할 수 있습니다.</p>

<ol>
  <li>x축 값을 회전하기</li>
</ol>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 30도만큼 x축 상의 데이터 값을 회전하기
</span><span class="n">plt</span><span class="p">.</span><span class="n">xticks</span><span class="p">(</span><span class="n">rotation</span><span class="o">=</span><span class="mi">30</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>축 설명 추가하기</li>
</ol>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># x축 설명 추가하기
</span><span class="n">plt</span><span class="p">.</span><span class="n">xlabel</span><span class="p">(</span><span class="s">'x축 이름'</span><span class="p">)</span>

<span class="c1"># y축 설명 추가하기
</span><span class="n">plt</span><span class="p">.</span><span class="n">ylabel</span><span class="p">(</span><span class="s">'y축 이름'</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>타이틀 추가하기</li>
</ol>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">plt</span><span class="p">.</span><span class="n">title</span><span class="p">(</span><span class="s">'plot의 이름'</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>line style 변경하기</li>
</ol>

<p>line style은 plt.plot()의 내부의 linestyle 옵션으로 변경 가능합니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># linestyle의 종류는 https://matplotlib.org/stable/gallery/lines_bars_and_markers/linestyles.html 참고
</span><span class="n">plt</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="s">'column1'</span><span class="p">,</span> <span class="s">'column2'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">,</span> <span class="n">linestyle</span><span class="o">=</span><span class="s">'solid'</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>line color 변경하기</li>
</ol>

<p>line color는 plt.plot()의 내부의 color 옵션으로 변경 가능합니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># color의 종류는 https://matplotlib.org/stable/gallery/color/named_colors.html 참고
</span><span class="n">plt</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="s">'column1'</span><span class="p">,</span> <span class="s">'column2'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">'red'</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>line 위의 데이터포인트마다 마커 추가하기</li>
</ol>

<p>Marker는 plt.plot() 내부의 marker 옵션으로 추가 가능합니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 세부 종류는 https://matplotlib.org/stable/api/markers_api.html 참고
</span><span class="n">plt</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="s">'column1'</span><span class="p">,</span> <span class="s">'column2'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">,</span> <span class="n">marker</span><span class="o">=</span><span class="s">'circle'</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>여러 그래프를 겹쳐서 그리기</li>
</ol>

<p>matplotlib.pyplot은 plt.show() 전의 모든 plot을 겹쳐서 나타내게 됩니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 별도로 설정하지 않더라도 여러개의 plot이 그려지는 경우 서로 색이 다르게끔 설정됨
</span><span class="n">plt</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="s">'column1'</span><span class="p">,</span> <span class="s">'column2'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">'column1'</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="s">'column3'</span><span class="p">,</span> <span class="s">'column2'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">,</span> <span class="n">label</span><span class="o">=</span><span class="s">'column3'</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>축 범위 조절하기</li>
</ol>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># x축 범위 조절하는 예시
</span><span class="n">plt</span><span class="p">.</span><span class="n">xlim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span> <span class="mi">100</span><span class="p">)</span>

<span class="c1"># y축 범위 조절하는 예시
</span><span class="n">plt</span><span class="p">.</span><span class="n">ylim</span><span class="p">(</span><span class="mi">0</span><span class="p">,</span><span class="mi">100</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>수평선, 수직선 추가하기</li>
</ol>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 수평선 추가하기
</span><span class="n">plt</span><span class="p">.</span><span class="n">axhline</span><span class="p">(</span><span class="n">수평선_추가할_값</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">'red'</span><span class="p">,</span> <span class="n">linestyle</span><span class="o">=</span><span class="s">'dashed'</span><span class="p">)</span>

<span class="c1"># 수직선 추가하기
</span><span class="n">plt</span><span class="p">.</span><span class="n">axvline</span><span class="p">(</span><span class="n">수직선_추가할_값</span><span class="p">,</span> <span class="n">color</span><span class="o">=</span><span class="s">'green'</span><span class="p">,</span> <span class="n">linestyle</span><span class="o">=</span><span class="s">'dotted'</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>텍스트 추가하기</li>
</ol>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">plt</span><span class="p">.</span><span class="n">text</span><span class="p">(</span><span class="n">텍스트를_추가할_x좌표</span><span class="p">,</span> <span class="n">y좌표</span><span class="p">,</span> <span class="s">'text 내용'</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>그리드 (grid) 추가하기</li>
</ol>

<p>plot의 가독성을 높이기 위해 자주 추가되는 기능 중 하나로, 격자선을 추가합니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">plt</span><span class="p">.</span><span class="n">grid</span><span class="p">()</span>
</code></pre></div></div>

<ol>
  <li>여러 그래프를 나눠서 그리기 (subplot)</li>
</ol>

<p>여러 그래프를 행과 열로 나눠서 그릴 수 있습니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 두 그래프를 위 아래로, 즉 2행 1열로 구성하여 나열하는 방법
# plt.plot() 전에 plt.subplot(행, 열, index)를 선언하여 사용
</span><span class="n">plt</span><span class="p">.</span><span class="n">subplot</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span><span class="mi">1</span><span class="p">,</span><span class="mi">1</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="s">'feature1'</span><span class="p">,</span> <span class="s">'target'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">)</span>

<span class="n">plt</span><span class="p">.</span><span class="n">subplot</span><span class="p">(</span><span class="mi">2</span><span class="p">,</span><span class="mi">2</span><span class="p">,</span><span class="mi">2</span><span class="p">)</span>
<span class="n">plt</span><span class="p">.</span><span class="n">plot</span><span class="p">(</span><span class="s">'feature2'</span><span class="p">,</span> <span class="s">'target'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>plot 크기 조절하기</li>
</ol>

<p>사용한다면 plt.plot() 전 가장 먼저 추가해야 할 기능입니다. 원하는 크기로 plot을 조절할 수 있습니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 10x10 크기로 figure 크기 조절
</span><span class="n">plt</span><span class="p">.</span><span class="n">figure</span><span class="p">(</span><span class="n">figsize</span><span class="o">=</span><span class="p">(</span><span class="mi">10</span><span class="p">,</span><span class="mi">10</span><span class="p">))</span>
</code></pre></div></div>

<p><br /></p>

<h4 id="seaborn-라이브러리">seaborn 라이브러리</h4>

<p>seaborn 라이브러리는 matplotlib 대비 사용법이 간단하여 많이 사용되는 라이브러리입니다.</p>

<p>matplotlib.pyplot의 다양한 그래프 꾸미기 함수와 혼용할 수 있다는 점이 매력적입니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">seaborn</span> <span class="k">as</span> <span class="n">sns</span>

<span class="c1"># bin이 n개인 dataframe의 feature column에 관한 히스토그램 그리기
</span><span class="n">sns</span><span class="p">.</span><span class="n">histplot</span><span class="p">(</span><span class="n">x</span><span class="o">=</span><span class="s">'feature'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">,</span> <span class="n">bins</span><span class="o">=</span><span class="n">n</span><span class="p">)</span>

<span class="n">plt</span><span class="p">.</span><span class="n">grid</span><span class="p">()</span>

<span class="n">plt</span><span class="p">.</span><span class="n">show</span><span class="p">()</span>
</code></pre></div></div>]]></content><author><name>Chanhyuk Yun</name></author><category term="Python" /><category term="Python" /><category term="Data analysis" /><summary type="html"><![CDATA[Date: 2024-09-10]]></summary></entry><entry><title type="html">Univariate data analysis</title><link href="https://chanhyukyun.github.io/data_analysis/kt_05_3/" rel="alternate" type="text/html" title="Univariate data analysis" /><published>2024-09-10T00:00:00+09:00</published><updated>2024-09-10T00:00:00+09:00</updated><id>https://chanhyukyun.github.io/data_analysis/kt_05_3</id><content type="html" xml:base="https://chanhyukyun.github.io/data_analysis/kt_05_3/"><![CDATA[<p>Date: 2024-09-10</p>

<p>이번 글에서는 변수 (feature)가 1개인 단변량 데이터의 분석에 관하여 다루도록 하겠습니다.</p>

<h4 id="단변량-데이터-univariate-data의-분석">단변량 데이터 (Univariate data)의 분석</h4>

<p>데이터 분석은 데이터가 숫자형인지, 범주형인지에 따라 방법이 달라집니다. 숫자형의 경우 정보의 대표값 (기초통계량)을 보고 분석하는 방법과 구간을 나누고 빈도를 파악하는 방법 (도수분포표)으로 나뉩니다.</p>

<ol>
  <li>숫자형 단변량 데이터 분석</li>
</ol>

<p>숫자형 단변량 데이터는 평균 (mean), 중앙값 (median), 최빈값 (mode)과 같은 정보의 대표값으로 요약할 수 있으며, 이러한 대표값을 기초통계량이라고 합니다.
파이썬에서는 matplotlib.pyplot.boxplot() 또는 seaborn.boxplot()을 사용하여 시각화 및 값을 얻을 수 있습니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">matplotlib.pyplot</span> <span class="k">as</span> <span class="n">plt</span>
<span class="kn">import</span> <span class="nn">seaborn</span> <span class="k">as</span> <span class="n">sns</span>

<span class="n">plt</span><span class="p">.</span><span class="n">boxplot</span><span class="p">(</span><span class="n">dataframe</span><span class="p">[</span><span class="s">'feature'</span><span class="p">])</span>
<span class="n">sns</span><span class="p">.</span><span class="n">boxplot</span><span class="p">(</span><span class="n">x</span><span class="o">=</span><span class="s">'feature'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">)</span>
<span class="n">sns</span><span class="p">.</span><span class="n">boxplot</span><span class="p">(</span><span class="n">dataframe</span><span class="p">[</span><span class="s">'feature'</span><span class="p">])</span>
</code></pre></div></div>

<p><img src="" alt="img1" /></p>

<p>가운데 box는 4분위수를 나타내며, IQR (Inter Quartile Range)를 사용하여 데이터의 유효한 최소값과 최대값을 구합니다.
여기서의 유효함은 절대적이지 않고 참고사항임을 명심해야 하며, 해당 범위 밖의 값은 이상치 (outlier)로 취급할 수 있습니다.</p>

<p><br /></p>

<ol>
  <li>범주형 단변량 데이터 분석</li>
</ol>

<p>범주형 단변량 데이터는 범주별로 개수를 세면 되므로, 범주별 빈도수 또는 비율을 계산하거나 시각화합니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">seaborn</span> <span class="k">as</span> <span class="n">sns</span>

<span class="c1"># 범주별 빈도수
</span><span class="n">series</span><span class="p">.</span><span class="n">value_counts</span><span class="p">()</span>

<span class="c1"># 범주별 비율
</span><span class="n">series</span><span class="p">.</span><span class="n">value_counts</span><span class="p">(</span><span class="n">normalize</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>

<span class="c1"># 시각화
</span><span class="n">sns</span><span class="p">.</span><span class="n">countplot</span><span class="p">(</span><span class="n">dataframe</span><span class="p">[</span><span class="s">'feature'</span><span class="p">])</span>
<span class="n">sns</span><span class="p">.</span><span class="n">countplot</span><span class="p">(</span><span class="n">x</span><span class="o">=</span><span class="s">'feature'</span><span class="p">,</span> <span class="n">data</span><span class="o">=</span><span class="n">dataframe</span><span class="p">)</span>
</code></pre></div></div>]]></content><author><name>Chanhyuk Yun</name></author><category term="Data_analysis" /><category term="Data analysis" /><category term="Python" /><summary type="html"><![CDATA[Date: 2024-09-10]]></summary></entry><entry><title type="html">Dataframe</title><link href="https://chanhyukyun.github.io/python/kt_04_1/" rel="alternate" type="text/html" title="Dataframe" /><published>2024-09-09T00:00:00+09:00</published><updated>2024-09-09T00:00:00+09:00</updated><id>https://chanhyukyun.github.io/python/kt_04_1</id><content type="html" xml:base="https://chanhyukyun.github.io/python/kt_04_1/"><![CDATA[<p>Date: 2024-09-09</p>

<p>이번 글에서는 데이터프레임 집계, 처리 방법에 관해 다루겠습니다.</p>

<h4 id="데이터프레임-집계-방법">데이터프레임 집계 방법</h4>

<p>데이터프레임 내의 특정 column별로 어떤 column을 집계할 때 .groupby() 메소드를 사용합니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">import</span> <span class="nn">pandas</span> <span class="k">as</span> <span class="n">pd</span>

<span class="n">path</span> <span class="o">=</span> <span class="s">'csv 파일 경로'</span>
<span class="n">dataframe1</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">read_csv</span><span class="p">(</span><span class="n">path</span><span class="p">)</span>

<span class="c1"># 집계기준변수: 'column 별로 집계' 할 때 그 column을 의미하며, 여러개가 들어갈 경우 list형태로 묶어서 입력
# as_index (default=True): 집계 기준이 되는 열이 index가 되도록 하는 옵션
# 집계대상변수: 집계할 column 대상. 역시 여러개를 올리려면 list형태로 묶어서 입력
# 집계함수: min, max, sum, mean, std 등
</span><span class="n">dataframe1</span><span class="p">.</span><span class="n">groupby</span><span class="p">(</span><span class="s">'집계기준변수'</span><span class="p">,</span> <span class="n">as_index</span><span class="o">=</span><span class="bp">False</span><span class="p">)[</span><span class="s">'집계대상변수'</span><span class="p">].</span><span class="n">집계함수</span><span class="p">()</span>

<span class="c1"># 집계함수를 여러개 동시에 사용하는 경우, .agg() 사용
</span><span class="n">dataframe1</span><span class="p">.</span><span class="n">groupby</span><span class="p">(</span><span class="s">'집계기준변수'</span><span class="p">,</span> <span class="n">as_index</span><span class="o">=</span><span class="bp">False</span><span class="p">)[</span><span class="s">'집계대상변수'</span><span class="p">].</span><span class="n">agg</span><span class="p">([</span><span class="s">'min'</span><span class="p">,</span> <span class="s">'max'</span><span class="p">,</span> <span class="s">'mean'</span><span class="p">])</span>
</code></pre></div></div>

<h4 id="데이터프레임-처리-전처리-방법">데이터프레임 처리 (전처리) 방법</h4>

<p>데이터프레임에서 데이터 구조를 만들기 위해 열 이름을 변경하거나, 열을 추가하거나, 데이터를 삭제하거나 값을 변경 및 결합하는 방법이 존재합니다.</p>

<ol>
  <li>데이터프레임 내의 열 이름 변경</li>
</ol>

<p>데이터프레임 내의 열 이름 변경은 한번에 모든 열의 이름을 바꾸는 방법과 원하는 특정 열의 이름을 바꾸는 방법이 있습니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 한번에 모든 열의 이름을 바꾸는 방법
# 변경할 열 뿐만 아니라 바꾸지 않을 열이라도 모두 입력해야 함
</span><span class="n">dataframe2</span><span class="p">.</span><span class="n">columns</span> <span class="o">=</span> <span class="p">[</span><span class="s">'Day'</span><span class="p">,</span> <span class="s">'Tip'</span><span class="p">,</span> <span class="s">'Quantity'</span><span class="p">,</span> <span class="s">'TotalBill'</span><span class="p">]</span>
<span class="n">dataframe2</span><span class="p">.</span><span class="n">columns</span> <span class="o">=</span> <span class="p">[</span><span class="s">'Day'</span><span class="p">,</span> <span class="s">'Tip'</span><span class="p">,</span> <span class="s">'Qty'</span><span class="p">,</span> <span class="s">'Bill'</span><span class="p">]</span>

<span class="c1"># 원하는 특정 열의 이름을 바꾸는 방법
</span><span class="n">dataframe3</span><span class="p">.</span><span class="n">columns</span> <span class="o">=</span> <span class="p">[</span><span class="s">'Day'</span><span class="p">,</span> <span class="s">'Tip'</span><span class="p">,</span> <span class="s">'Quantity'</span><span class="p">,</span> <span class="s">'TotalBill'</span><span class="p">]</span>
<span class="n">dataframe3</span><span class="p">.</span><span class="n">rename</span><span class="p">(</span><span class="n">columns</span><span class="o">=</span><span class="p">{</span><span class="s">'Qty'</span><span class="p">:</span> <span class="s">'Quantity'</span><span class="p">,</span> <span class="s">'TotalBill'</span><span class="p">:</span> <span class="s">'Bill'</span><span class="p">},</span> <span class="n">inplace</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>데이터프레임에 새로운 열 추가</li>
</ol>

<p>데이터프레임에서 새로운 열을 추가하는 방법은 열의 맨 뒤에 추가하는 방법과 원하는 열 순서에 추가하는 방법이 존재합니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 열의 맨 뒤에 추가하는 방법
</span><span class="n">dataframe3</span><span class="p">[</span><span class="s">'새로운 열 이름'</span><span class="p">]</span> <span class="o">=</span> <span class="n">시리즈</span> <span class="ow">or</span> <span class="n">scalar</span> <span class="n">값</span>

<span class="c1"># 원하는 열 순서에 새로운 열을 추가하는 방법
# column_index에 -1 안 됨
</span><span class="n">dataframe3</span><span class="p">.</span><span class="n">insert</span><span class="p">(</span><span class="n">column_index</span><span class="p">,</span> <span class="s">'새로운 열 이름'</span><span class="p">,</span> <span class="n">추가할</span> <span class="n">데이터</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>데이터프레임 내의 데이터 삭제</li>
</ol>

<p>데이터프레임에서 행 또는 열 데이터 삭제는 .drop() 메소드를 사용합니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 행 삭제
# axis=0 (행 삭제)가 default
# 지울 행이 복수인 경우, list로 입력 가능
</span><span class="n">dataframe3</span><span class="p">.</span><span class="n">drop</span><span class="p">(</span><span class="n">지울_행_index</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">inplace</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>

<span class="c1"># 열 삭제
# 지울 열이 복수인 경우, list로 입력 가능
</span><span class="n">dataframe3</span><span class="p">.</span><span class="n">drop</span><span class="p">(</span><span class="s">'지울 열 이름'</span><span class="p">,</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">inplace</span><span class="o">=</span><span class="bp">True</span><span class="p">)</span>
</code></pre></div></div>

<ol>
  <li>데이터프레임 내의 값 변경</li>
</ol>

<p>데이터프레임 내의 값을 변경하는 방법은 크게 다섯 가지 존재합니다.</p>

<ul>
  <li>열 전체 값을 변경하는 방법</li>
</ul>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">dataframe4</span><span class="p">[</span><span class="s">'column1'</span><span class="p">]</span> <span class="o">=</span> <span class="n">scalar값</span>
</code></pre></div></div>

<p><br /></p>

<ul>
  <li>조건에 의한 값 변경 방법</li>
</ul>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># .loc 메소드 사용
</span><span class="n">dataframe4</span><span class="p">.</span><span class="n">loc</span><span class="p">[</span><span class="n">dataframe4</span><span class="p">[</span><span class="s">'column1'</span><span class="p">]</span> <span class="o">&lt;</span> <span class="n">threshold_value</span><span class="p">,</span> <span class="s">'column1'</span><span class="p">]</span> <span class="o">=</span> <span class="n">scalar값</span>
</code></pre></div></div>

<p><br /></p>

<ul>
  <li>조건에 의한 값 변경 방법 2</li>
</ul>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># np.where 사용
</span><span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span>
<span class="n">dataframe4</span><span class="p">[</span><span class="s">'column1'</span><span class="p">]</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">where</span><span class="p">(</span><span class="n">dataframe</span><span class="p">[</span><span class="s">'column1'</span><span class="p">]</span> <span class="o">&lt;</span> <span class="n">threshold_value</span><span class="p">,</span> <span class="n">참일_때_값</span><span class="p">,</span> <span class="n">거짓일_때_값</span><span class="p">)</span>
</code></pre></div></div>

<p><br /></p>

<ul>
  <li>.map() 메소드 사용</li>
</ul>

<p>기존 값을 다른 값으로 매핑할 때 사용</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># 기존 male 값을 1로, female을 0으로 매핑
</span><span class="n">dataframe5</span><span class="p">[</span><span class="s">'Sex'</span><span class="p">]</span> <span class="o">=</span> <span class="n">dataframe5</span><span class="p">[</span><span class="s">'Sex'</span><span class="p">].</span><span class="nb">map</span><span class="p">({</span><span class="s">'male'</span><span class="p">:</span> <span class="mi">1</span><span class="p">,</span> <span class="s">'female'</span><span class="p">:</span> <span class="mi">0</span><span class="p">})</span>
</code></pre></div></div>

<p><br /></p>

<ul>
  <li>pandas.cut() 함수 사용</li>
</ul>

<p>숫자형 데이터를 범주형으로 변환 시 사용</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># bins가 integer인 경우, 데이터의 최소, 최대 범위를 균등하게 나눔
# labels: 나눈 데이터에 채울 범주형데이터
</span><span class="n">dataframe6</span><span class="p">[</span><span class="s">'Age_group'</span><span class="p">]</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">cut</span><span class="p">(</span><span class="n">dataframe6</span><span class="p">[</span><span class="s">'Age'</span><span class="p">],</span> <span class="n">bins</span><span class="o">=</span><span class="mi">3</span><span class="p">,</span> <span class="n">labels</span><span class="o">=</span><span class="p">[</span><span class="s">'young'</span><span class="p">,</span> <span class="s">'junior'</span><span class="p">,</span> <span class="s">'senior'</span><span class="p">])</span>

<span class="c1"># 구간을 임의로 정하고 싶은 경우, bins에 경계값을 list로 넣어줌
# np.inf와 -np.inf 활용 가능
# 기본적으로 경계값은 (bin_n, bin_n+1] 의 구간으로 나뉘지만, right=True(default)를 수정하여 변경 가능
# 최소값을 포함하고 싶다면 include_lowest=True로 설정
</span><span class="n">dataframe6</span><span class="p">[</span><span class="s">'Age_group'</span><span class="p">]</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">cut</span><span class="p">(</span><span class="n">dataframe6</span><span class="p">[</span><span class="s">'Age'</span><span class="p">],</span> <span class="n">bins</span><span class="o">=</span><span class="p">[</span><span class="mi">0</span><span class="p">,</span> <span class="mi">40</span><span class="p">,</span> <span class="mi">50</span><span class="p">,</span> <span class="n">np</span><span class="p">.</span><span class="n">inf</span><span class="p">],</span> <span class="n">labels</span><span class="o">=</span><span class="p">[</span><span class="s">'young'</span><span class="p">,</span> <span class="s">'junior'</span><span class="p">,</span> <span class="s">'senior'</span><span class="p">])</span>

<span class="c1"># bins 구간을 벗어나는 데이터는 NA (검증 필요!)
</span></code></pre></div></div>

<ol>
  <li>데이터프레임의 결합</li>
</ol>

<p>데이터프레임을 결합하는 방법으로는 행 또는 열로 그냥 붙이는 방법과, 특정 column 값을 기준으로 결합하는 방법이 존재합니다.</p>

<ul>
  <li>pd.concat()</li>
</ul>

<p>pd.concat()은 행 또는 열로 붙이는 방법으로, axis 값을 통해 가로 방향(열)으로 합칠지, 세로 방향(행)으로 합칠지 결정합니다.</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># pd.concat([df1, df2], axis=0, join='outer')
# 병합할 데이터프레임을 리스트로 묶어 병합
# join='outer' (default)
# axis=0 (default)
</span>
<span class="c1"># 세로 방향 (행)으로 붙일 경우, axis=0
# 열 이름이 병합의 기준이 됨
# join이 'outer'인 경우, 모든 행과 열을 합치며, 'inner'인 경우 같은 행과 열만 합침
</span><span class="n">dataframe7</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">concat</span><span class="p">([</span><span class="n">df1</span><span class="p">,</span> <span class="n">df2</span><span class="p">,</span> <span class="p">...,</span> <span class="n">dfn</span><span class="p">],</span> <span class="n">axis</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">join</span><span class="o">=</span><span class="s">'inner'</span><span class="p">)</span>

<span class="c1"># 가로 방향 (열)로 붙일 경우, axis=1
# 행의 index가 병합의 기준이 됨
# join이 'outer'인 경우, 모둔 행과 열을 합치며, 'inner'인 경우 같은 행과 열만 합침
</span><span class="n">dataframe8</span> <span class="o">=</span> <span class="n">pd</span><span class="p">.</span><span class="n">concat</span><span class="p">([</span><span class="n">df1</span><span class="p">,</span> <span class="n">df2</span><span class="p">,</span> <span class="p">...,</span> <span class="n">dfn</span><span class="p">],</span> <span class="n">axis</span><span class="o">=</span><span class="mi">1</span><span class="p">,</span> <span class="n">join</span><span class="o">=</span><span class="s">'outer'</span><span class="p">)</span>
</code></pre></div></div>

<ul>
  <li>pd.merge()</li>
</ul>

<p>지정한 column의 값을 기준으로 병합하며, 따라서 가로 방향으로만 병합함</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="s">'''
* how *
  'inner': 같은 값만 붙임
  'outer': 모든 값을 붙임
  'left': 왼쪽 데이터프레임은 모두, 오른쪽은 같은 값만 병합
  'right': 오른쪽 데이터프레임은 모두, 왼쪽은 같은 값만 병합

* on *
기준으로 삼을 key column
입력값으로 주어지지 않는 경우 default로는 겹치는 columns를 기준으로 병합
'''</span>
<span class="n">pd</span><span class="p">.</span><span class="n">merge</span><span class="p">(</span><span class="n">left</span><span class="p">,</span> <span class="n">right</span><span class="p">,</span> <span class="n">how</span><span class="o">=</span><span class="s">'inner'</span><span class="p">,</span> <span class="n">on</span><span class="o">=</span><span class="bp">None</span><span class="p">)</span>
<span class="n">left</span><span class="p">.</span><span class="n">merge</span><span class="p">(</span><span class="n">right</span><span class="p">,</span> <span class="n">how</span><span class="o">=</span><span class="s">'inner'</span><span class="p">,</span> <span class="n">on</span><span class="o">=</span><span class="bp">None</span><span class="p">)</span>
</code></pre></div></div>

<p>주로 Products, Customers, Sales 데이터에서 많이 사용됨</p>

<ul>
  <li>.pivot() 메소드</li>
</ul>

<p>.groupby() 메소드로 집계된 데이터를 재구성할 때 사용</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">dataframe9</span> <span class="o">=</span> <span class="n">dataframe8</span><span class="p">.</span><span class="n">groupby</span><span class="p">([</span><span class="s">'column1'</span><span class="p">,</span> <span class="s">'column2'</span><span class="p">],</span> <span class="n">as_index</span><span class="o">=</span><span class="bp">False</span><span class="p">)[</span><span class="s">'column3'</span><span class="p">].</span><span class="n">function</span><span class="p">()</span>
<span class="n">dataframe10</span> <span class="o">=</span> <span class="n">dataframe9</span><span class="p">.</span><span class="n">pivot</span><span class="p">(</span><span class="n">index</span><span class="o">=</span><span class="s">'index로 삼을 column명'</span><span class="p">,</span> <span class="n">columns</span><span class="o">=</span><span class="s">'열로 볼 column명'</span><span class="p">,</span> <span class="n">values</span><span class="o">=</span><span class="s">'값으로 나타낼 column명'</span><span class="p">)</span>
</code></pre></div></div>]]></content><author><name>Chanhyuk Yun</name></author><category term="Python" /><category term="Python" /><summary type="html"><![CDATA[Date: 2024-09-09]]></summary></entry></feed>